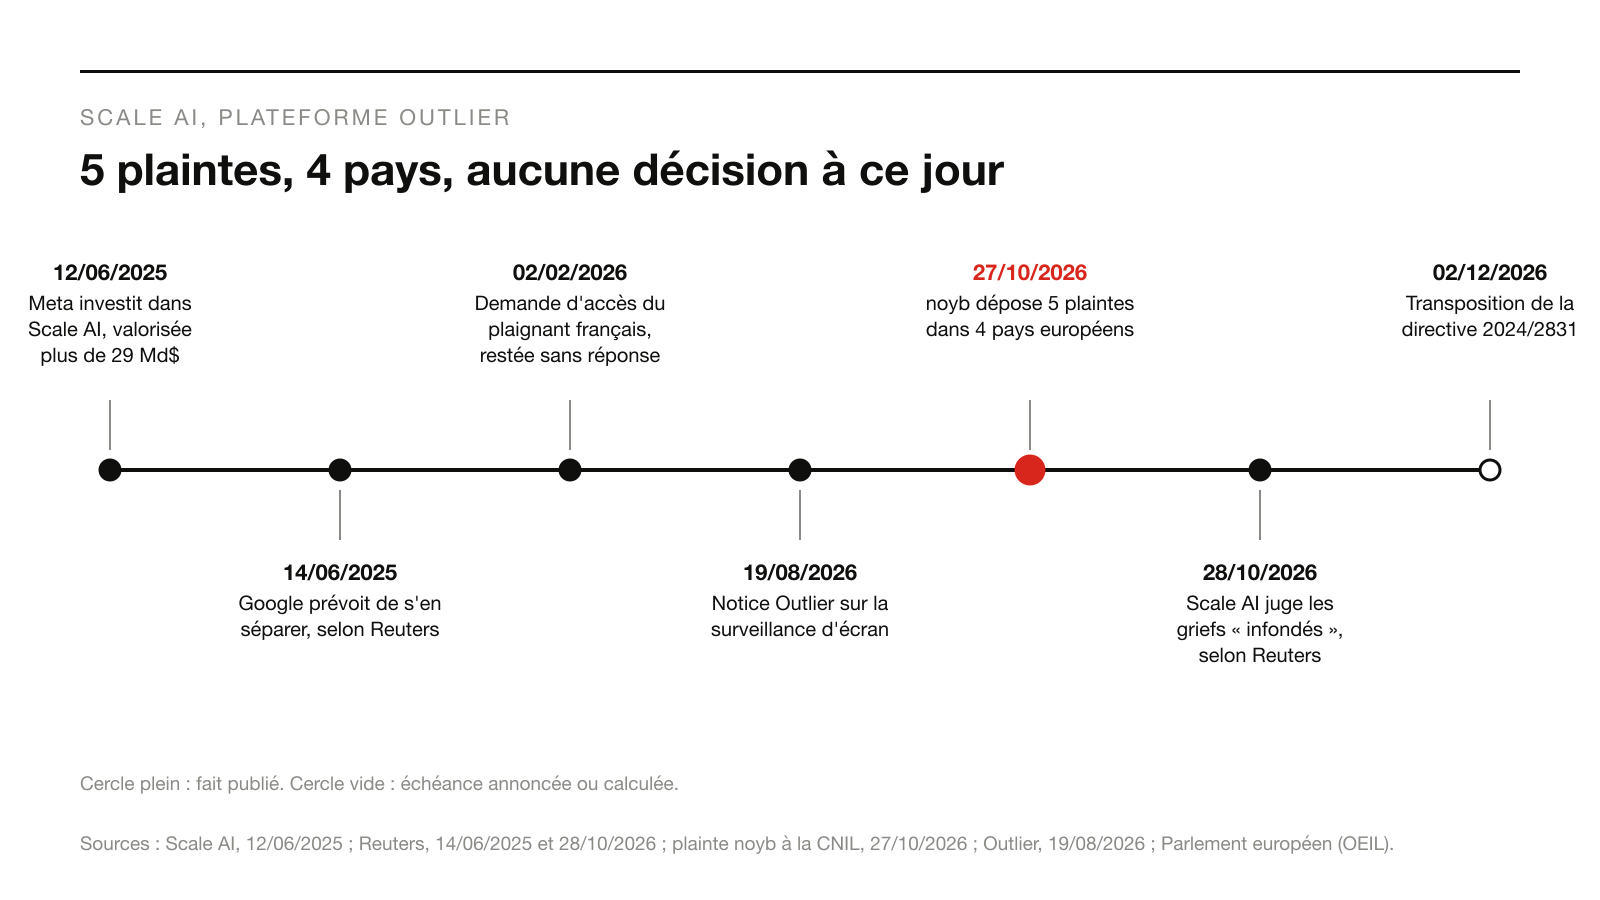
Le 27 octobre 2026, l’association autrichienne noyb, avec Intérêt à Agir, DiPLab et Reversing.Works, a déposé 5 plaintes contre Scale AI, société de San Francisco qui exploite Outlier, une plateforme où des indépendants rédigent des requêtes, notent et corrigent les réponses de modèles d’IA. Les plaintes visent la CNIL en France, le Garante en Italie, l’Autoriteit Persoonsgegevens aux Pays-Bas et, à 2 reprises, la Datenschutzbehörde en Autriche. Selon le communiqué de noyb, Outlier fait travailler plus de 900 000 personnes et compte parmi ses clients Meta, OpenAI et Google.
Le lendemain, Scale AI a rejeté les plaintes. Dans une déclaration transmise à Reuters, l’entreprise les juge « infondées et inexactes » et affirme que les pratiques de la plateforme sont portées à la connaissance des contributeurs et soumises à leur consentement. Aucune autorité ne s’est prononcée.
Derrière chaque modèle d’IA vendu à une entreprise se tient une chaîne de travail humain et de prestataires techniques que l’acheteur ne voit pas, et dont les risques juridiques lui reviennent par le haut.
Ce que les plaintes documentent
Les 5 textes, publiés caviardés, suivent le même plan. La plainte adressée à la CNIL décrit un travailleur qui a vérifié son identité pour ouvrir un compte, puis réalisé environ 50 tâches en avril 2025 : comparer et noter les réponses de modèles conversationnels. Il a ensuite enregistré le trafic de son navigateur sur la plateforme, dans des fichiers techniques joints en annexe.
Ces enregistrements font apparaître, selon la plainte française, des traceurs de 18 tiers, dont Fullstory, Sprig, LinkedIn, TikTok, Facebook, Snapchat, Google Analytics et Persona. Sur les 1 171 requêtes de ses captures, 383, soit 33 %, partaient vers ces tiers, dont 118 vers Facebook, selon le graphique de la plainte et un calcul d’ELMARQ ; les plaintes italienne et néerlandaise en recensent 13 et 7. Le traceur de Facebook transmettrait un identifiant du travailleur, un identifiant de projet et la raison pour laquelle aucune tâche ne lui est proposée. Celui de Fullstory, un outil de « rejeu de session », enverrait une requête toutes les quelques secondes avec les mouvements du curseur et le contenu saisi dans les champs de formulaire. La plainte cite le projet de recommandation de la CNIL sur ces outils, soumis à consultation jusqu’au 22 avril 2026.
Pour la vérification d’identité, le plaignant français a dû téléverser une pièce d’identité puis activer sa caméra pour enregistrer une vidéo de son visage, auprès du prestataire Persona, et cela « à intervalles irréguliers ». La plainte relève que Persona fait appel à environ 15 sous-traitants, dont OpenAI et Anthropic. Selon la plainte, la politique de confidentialité de Persona prévoyait, jusqu’au 9 avril 2026, la possibilité d’utiliser les pièces d’identité et les selfies téléversés pour entraîner et améliorer son propre service. Enfin, la demande d’accès envoyée le 2 février 2026 à Outlier n’a pas reçu de réponse ; selon Reuters, 4 travailleurs ont fait de telles demandes entre décembre 2025 et mai 2026, sans réponse.
Le fondement juridique est commun : minimisation des données (article 5(1)(c) du RGPD), protection des données dès la conception (25(1)), choix d’un sous-traitant offrant des garanties (28(1)), droit d’accès et délai de réponse (15 et 12(3)), et, pour les traceurs, la règle nationale du consentement, en France l’article 82 de la loi Informatique et Libertés. Les plaignants demandent un constat, une injonction de répondre et une enquête étendue à la décision automatisée, et suggèrent une amende. Scale AI n’ayant pas d’établissement principal dans l’Union, chaque autorité est saisie séparément, sans guichet unique.
Ce qui reste contesté ou inconnu
Rien n’est jugé. Les faits reposent sur les captures des plaignants, dont les annexes ne sont pas publiées. Le nombre de traceurs n’est pas stabilisé : Reuters écrit « jusqu’à 19 » ; noyb en compte 18 côté français et « certainement plus », selon The Record.
La réponse de Scale AI, rapportée par Reuters le 28 octobre, porte sur 3 points. L’entreprise dit utiliser des « outils standard » pour vérifier les identités, prévenir la fraude et protéger les projets. Un porte-parole précise que certains projets utilisent un outil distinct, qui enregistre le temps passé et l’activité de l’écran, et que les contributeurs choisissent d’y adhérer puis l’activent eux-mêmes. Enfin, Scale ne vendrait pas ces données et ne s’en servirait pas pour entraîner les modèles de ses clients.
Cette réponse appelle 2 remarques, sans rien trancher. D’abord, l’outil d’écran qu’elle décrit n’est pas l’objet principal des plaintes, qui visent des traceurs de tiers et le prestataire d’identité. Ensuite, la notice d’Outlier sur la surveillance d’écran, en vigueur depuis le 19 août 2026, ne fonde pas ce traitement sur le consentement : « Nous ne nous appuyons pas sur votre consentement et nous ne le demandons pas », écrit-elle, la base retenue étant l’intérêt légitime. La surveillance y est une « exigence contractuelle » des projets concernés : qui la refuse n’accumule pas de temps payé. Le texte exclut la caméra, le micro et la frappe au clavier. Adhérer à un projet n’est pas consentir au sens du RGPD ; les autorités diront quelle base vaut pour quels outils.
La liste actuelle des clients n’est pas établie non plus. Scale AI a annoncé le 12 juin 2025 un investissement de Meta qui la valorisait à plus de 29 milliards de dollars, en précisant que Meta deviendrait actionnaire minoritaire ; Reuters chiffre sa part à 49 %. Le 14 juin 2025, Reuters rapportait, sur la foi de 5 sources, que Google, alors son principal client, prévoyait de s’en séparer.
Le mécanisme : une chaîne où chaque maillon ajoute des tiers
La plainte française décrit le circuit. Un client envoie des données à Scale AI, qui attribue par algorithme une tâche à un travailleur ; la plateforme contrôle ensuite le résultat et confie la correction à une autre personne. Le travail se fait sur l’appareil personnel de l’annotateur, dans un navigateur où la plateforme a intégré des services d’analyse, de publicité et d’identité, chacun avec ses sous-traitants.
Pour l’acheteur d’un modèle ou de données annotées, ce circuit pose 3 questions. La 1re est la provenance : un modèle ajusté par des annotations humaines incorpore leurs conditions de production, et un litige sur ces conditions devient un risque de réputation pour toute la chaîne. La 2e est la confidentialité. En juin 2025, selon Reuters, des laboratoires concurrents de Meta craignaient de révéler leurs priorités de recherche à travers les projets confiés à Scale. Or la plainte française décrit un identifiant de projet transmis au traceur d’un réseau social : si le fait est confirmé, l’information sur le travail d’un client sort par une voie que ni ce client ni le travailleur n’ont choisie. La 3e est réglementaire. La directive (UE) 2024/2831 sur le travail via une plateforme doit être transposée au plus tard le 2 décembre 2026, selon l’Observatoire législatif du Parlement européen. Elle encadre la surveillance et la décision automatisées et interdit à ces systèmes de traiter certaines données, dont des données biométriques ; les plaintes invoquent son considérant 41, qui privilégie la comparaison d’un visage à un seul document plutôt qu’à une base entière.
Le 13 novembre 2024, le Garante a infligé 5 millions d’euros à Foodinho, filiale du groupe Glovo, dans une décision que les plaintes citent pour sa critique de la reconnaissance faciale imposée aux livreurs. Un annotateur d’IA travaille seul chez lui, mais le droit européen tend à le regarder comme un livreur : un travailleur dont la plateforme organise et contrôle l’activité.
L’arbitrage déplacé : qui décide de la surveillance tolérable
Sur le papier, la décision appartient à 4 autorités nationales, saisies chacune pour son plaignant et non coordonnées par un guichet unique. Nous l’avions décrit le 18 octobre à propos de la sanction de Xandr en Norvège : faute d’établissement principal dans l’Union, chaque autorité instruit seule, et une clause de contrat ne transfère pas la responsabilité d’un intermédiaire à son partenaire. Les mêmes faits peuvent recevoir des réponses différentes selon le pays.
Dans les faits, l’arbitrage se fait plus tôt. Le travailleur ne choisit que d’accepter ou de refuser une tâche. Le laboratoire client choisit son fournisseur d’annotations sur le prix, la vitesse et l’expertise. L’entreprise utilisatrice, au bout, achète un modèle sans connaître ses fournisseurs de 2e rang. Le choix par défaut est donc fait par contrat, entre un laboratoire et un sous-traitant, et le coût d’un éventuel manquement remonte vers des acheteurs qui n’ont rien décidé. La conformité d’un modèle d’IA se joue en partie chez des prestataires que son acheteur ne voit jamais, et c’est à lui de demander à les voir.
Les faits datés qui trancheront
La lecture proposée ici se vérifiera sur des faits datés. Le 2 décembre 2026, la directive sur le travail via une plateforme devra être transposée. En France, le gouvernement indiquait, dans une réponse publiée le 21 juillet 2026, qu’une mission de concertation devait rendre ses conclusions avant la fin du 3e trimestre ; l’absence de texte à cette date laisserait la question aux seules autorités de protection des données.
Chacune des 4 autorités dira si elle enquête, et si elle s’intéresse à l’attribution des tâches par algorithme. Une injonction de répondre aux demandes d’accès, dont le délai légal est dépassé selon les plaintes, serait le signal le plus rapide. Enfin, la notice du 19 août 2026, si elle évolue, dira si Scale AI aligne sa base juridique sur le consentement qu’elle invoque publiquement.
Les faits proviennent du communiqué de noyb du 27 octobre 2026 et des 5 plaintes caviardées publiées le même jour (dossiers C109-01 à C109-05), lues en entier ; leurs annexes techniques ne sont pas publiées. Le nombre de tiers par plainte est un décompte d’ELMARQ. La position de Scale AI est rapportée selon les dépêches de Reuters des 27 et 28 octobre 2026, dans leurs reprises par Yahoo et SRN News, et selon The Record. La notice d’Outlier du 19 août 2026, le communiqué de Scale AI du 12 juin 2025, la décision du Garante du 13 novembre 2024 et le projet de la CNIL sont cités d’après leur texte. La part de 49 % de Meta et l’intention de Google sont attribuées à Reuters ; la date de transposition, à l’Observatoire législatif du Parlement européen. Les citations de l’anglais sont traduites par ELMARQ.