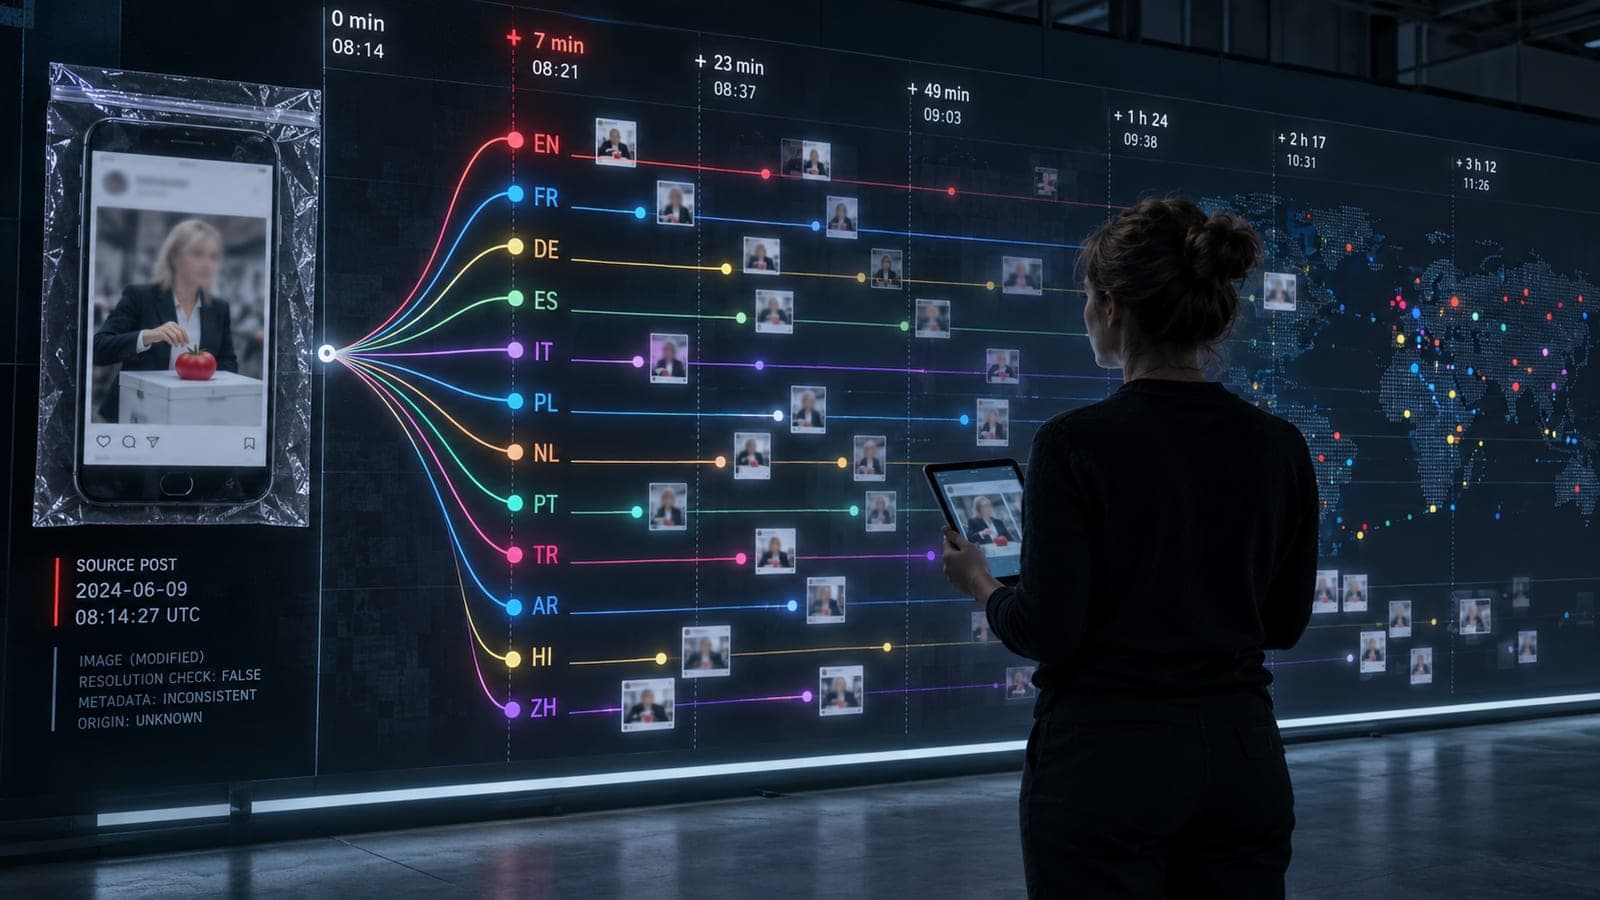
Le 22 juillet 2026 à 16 heures 08, heure d’Europe centrale, une chaîne Telegram publie une image. On y voit Ursula von der Leyen lancer une tomate. La photographie est authentique et montre en réalité la présidente de la Commission européenne glissant son bulletin dans l’urne lors des élections européennes du 9 juin 2024 ; elle a été retouchée. Le message qui l’accompagne affirme que Politico aurait révélé que l’Union européenne refuse les tomates arméniennes.
Politico n’a jamais publié un tel article. Des organisations de vérification, dont Myth Detector, l’ont établi. Et la réalité économique était inversée : selon l’enquête publiée le 29 septembre 2026 par le Digital Forensic Research Lab de l’Atlantic Council et le média arménien CivilNet, c’est la Russie qui avait imposé fin mai 2026 un embargo sur une série de produits agricoles arméniens, tandis que l’Union européenne ouvrait au contraire son marché aux marchandises arméniennes.
Une fausse information démentie par des vérificateurs n’aurait, en soi, aucun intérêt. Ce que DFRLab et CivilNet apportent tient à la mesure de sa propagation, et cette mesure est d’un genre que nous n’avions pas encore dans nos dossiers.
8 minutes pour changer de langue, 29 heures pour en atteindre 18
Le récit existe en anglais 8 minutes après la publication initiale sur Telegram, porté par un compte X suivi par près de 800 000 abonnés. En moins de 29 heures, les chercheurs le retrouvent dans 18 langues : russe, anglais, tchèque, italien, portugais, serbe, allemand, bulgare, arménien, français, espagnol, roumain, grec, ukrainien, arabe, coréen, finnois et vietnamien.
Le corpus analysé pour cette phase rassemble plus de 380 publications originales, collectées du 22 au 31 juillet 2026 au moyen des outils Osavul, Meta Content Library et Meltwater. Le détail méthodologique a son importance : il s’agit de publications originales, non de reprises, ce qui écarte l’objection du simple partage en cascade.
Or 29 heures est un délai inférieur à celui que demande une vérification sérieuse. Établir que Politico n’a rien publié suppose de consulter l’éditeur, de chercher dans ses archives, parfois d’obtenir une réponse. Pendant ce temps, le récit a changé de langue 18 fois. Nous tenons là une grandeur mesurable, que nous appellerons pour l’usage interne le délai de franchissement linguistique, et qui se substitue avantageusement à la notion vague de viralité.
L’infrastructure existait avant le sujet
Le second relevé du rapport explique comment un tel délai est possible. Entre le 19 août et le 19 septembre 2026, 2 chaînes Telegram, @channelredline et @llordofwar, ont publié le même contenu 11 348 fois, avec un écart médian de 1 seconde entre les 2 publications. Un écart de 1 seconde ne se produit pas entre 2 rédactions qui se lisent l’une l’autre.
Aussi le récit des tomates n’a-t-il pas construit ce réseau. Il l’a trouvé disponible. La capacité de distribution préexiste au sujet à distribuer, et la crise ne fait que lui fournir son contenu du jour. C’est la même économie que celle que nous décrivions à propos du relais rémunéré nigérian, où l’opération n’a pas à fabriquer ses porteurs puisqu’elle peut les louer : ici encore, le coût d’entrée a déjà été payé par quelqu’un d’autre, avant que le sujet n’existe.
Le relais francophone ne se présente pas comme français
Le troisième relevé intéresse directement une direction de la communication française, et c’est celui que les reprises du rapport ont le moins commenté.
Les chercheurs identifient un groupe de 3 chaînes fonctionnant comme un ensemble automatisé et multilingue, chacune se présentant comme un média d’information localisé : @csrc_agency1 en russe, @AnaDeInfo en allemand et @afriqueactual en français. Entre le 1er juillet et le 16 septembre 2026, ils recensent 413 séquences où une publication en russe est suivie de sa version allemande puis de sa version française en moins de 30 secondes. Cet ordre récurrent et cette vitesse constituent, selon eux, un indice fort de distribution automatisée et centralisée.
Le nom de la chaîne francophone mérite qu’on s’y arrête. Elle ne se présente pas comme un média français, mais comme un média africain de langue française. Une veille française qui surveille la presse nationale, les comptes hexagonaux et les relais militants connus ne regarde pas ce périmètre, et le contenu y circule pourtant dans sa langue. Précisons immédiatement ce que cela ne dit pas : rien dans le rapport ne met en cause des médias africains réels, et une chaîne Telegram qui se donne une identité africaine n’est pas plus africaine qu’elle n’est journalistique. La conséquence est d’ordre pratique : le point d’entrée du français dans ce dispositif se situe hors du champ que la plupart des dispositifs de veille française ont défini comme le leur.
Pourquoi le dispositif emprunte le nom de Politico
Le récit aurait pu être présenté comme l’affirmation d’un média russe. Il ne l’a pas été. Il a été attribué à Politico, et ce choix fait une partie du travail.
L’attribution fournit 3 choses que l’émetteur ne possède pas : la réputation d’un média établi, une localisation européenne cohérente avec le sujet traité, et l’apparence d’un tiers indépendant qui viendrait confirmer un grief. Le lecteur ne reçoit plus une opinion pro-russe sur l’Europe, il reçoit une information européenne sur l’Europe. Nous avons documenté la même mécanique lorsqu’elle porte sur des personnes, avec la fabrication de faux experts cités par de vrais médias : l’opération ne cherche pas à être crue sur parole, elle cherche à être citée par quelqu’un qu’on croit.
Puis la multiplication des langues ajoute un effet que le contenu seul n’aurait pas produit. Un lecteur qui retrouve la même affirmation en français, en allemand et en espagnol conclut raisonnablement que plusieurs sources indépendantes y sont parvenues séparément. Les 413 séquences mesurées montrent qu’il s’agit d’une seule opération de publication. Le conseil ordinaire de recouper ses sources cesse de protéger dès lors que les sources recoupées sortent du même flux.
Ce que le rapport attribue, et ce qu’il n’attribue pas
DFRLab qualifie le réseau observé de pro-Kremlin et documente des liens avec des actifs ayant déjà relayé des campagnes antérieures. Sur X, 74 comptes ayant diffusé cette fausse information possèdent un historique documenté d’amplification de campagnes précédemment rattachées à Storm-1516, dont 18 l’ont publiée plusieurs fois.
Le rapport ne publie pas, en revanche, d’ordre étatique déclenchant cette campagne particulière, et il n’attribue pas l’opération au gouvernement russe. La formulation exacte, coordination et automatisation documentées, acteurs pro-Kremlin, alignement avec des infrastructures déjà observées, est plus faible que « Moscou a orchestré » et infiniment plus solide. Nous appliquons ici la même discipline que dans notre analyse des trois machines derrière les ingérences russes, où nous montrions qu’un même récit peut être porté par un appareil d’État, par un écosystème commercial et par des amplificateurs sincères, et que les confondre conduit à se tromper d’adversaire comme de réponse. Voir notre doctrine d’attribution, qui établit qu’un lien technique entre 2 actifs n’implique pas le commanditaire de l’un dans l’action de l’autre.
La grille de mesure que ce cas rend possible
L’intérêt durable de cette enquête tient moins aux tomates qu’à la série d’horodatages qu’elle rend disponibles, et qui peut être réappliquée à la campagne suivante. Une opération se décrit par 6 instants : la première injection, la première traduction, la première audience de masse, l’apparition de la première source secondaire apparemment indépendante, le premier démenti documenté, et la première correction visible sur la plateforme ou chez le média usurpé.
Pour le cas arménien, les 3 premiers sont connus, respectivement 16 heures 08 le 22 juillet, 16 heures 16 le même jour, et le même moment puisque la traduction anglaise et l’audience de masse coïncident. La distance entre le troisième et le cinquième est ce qui détermine réellement l’exposition, et cette distance se compte ici en jours quand la propagation se compte en minutes.
Une organisation qui voudrait s’en servir n’a pas besoin des outils des chercheurs. Elle a besoin de savoir, pour son propre nom et pour ceux de ses dirigeants, dans combien de langues une affirmation la concernant peut exister avant qu’elle n’en soit informée. La réponse, dans la plupart des cas que nous observons, est qu’elle l’apprend par un journaliste qui l’appelle.
Les limites de ce dossier
Elles tiennent à la nature des données. Les relevés proviennent d’outils commerciaux de collecte dont la couverture de Telegram et de X est partielle ; un décompte de publications originales dépend du périmètre interrogé. Un écart médian de 1 seconde entre 2 chaînes établit une synchronisation technique, non l’identité de leur opérateur. Enfin, le fait qu’un compte ait relayé par le passé des contenus rattachés à Storm-1516 ne démontre pas qu’il agisse sur instruction aujourd’hui, et certains amplificateurs peuvent être sincères.
Rien de tout cela n’affaiblit le constat central, qui ne dépend d’aucune attribution : un grief agricole local a existé en 18 langues en moins de 29 heures, porté par une infrastructure construite avant lui, et il a emprunté pour cela le nom d’un média qui n’en savait rien.