La question du titre appelle une réponse chiffrée, et la recherche publiée ne la donne pas encore. Au 11 mars 2026, nous n’avons identifié aucune étude publique, avec protocole et données, qui mesure la fréquence à laquelle ChatGPT, Gemini, Claude ou Perplexity décrivent mal une entreprise. Ce qui existe est voisin. Selon Forrester (2024), 89 % des acheteurs B2B interrogés déclarent utiliser l’IA générative dans au moins une étape de leurs achats, un usage déclaré et non une mesure de son poids dans la décision.
Les taux d’erreur mesurés portent sur l’actualité
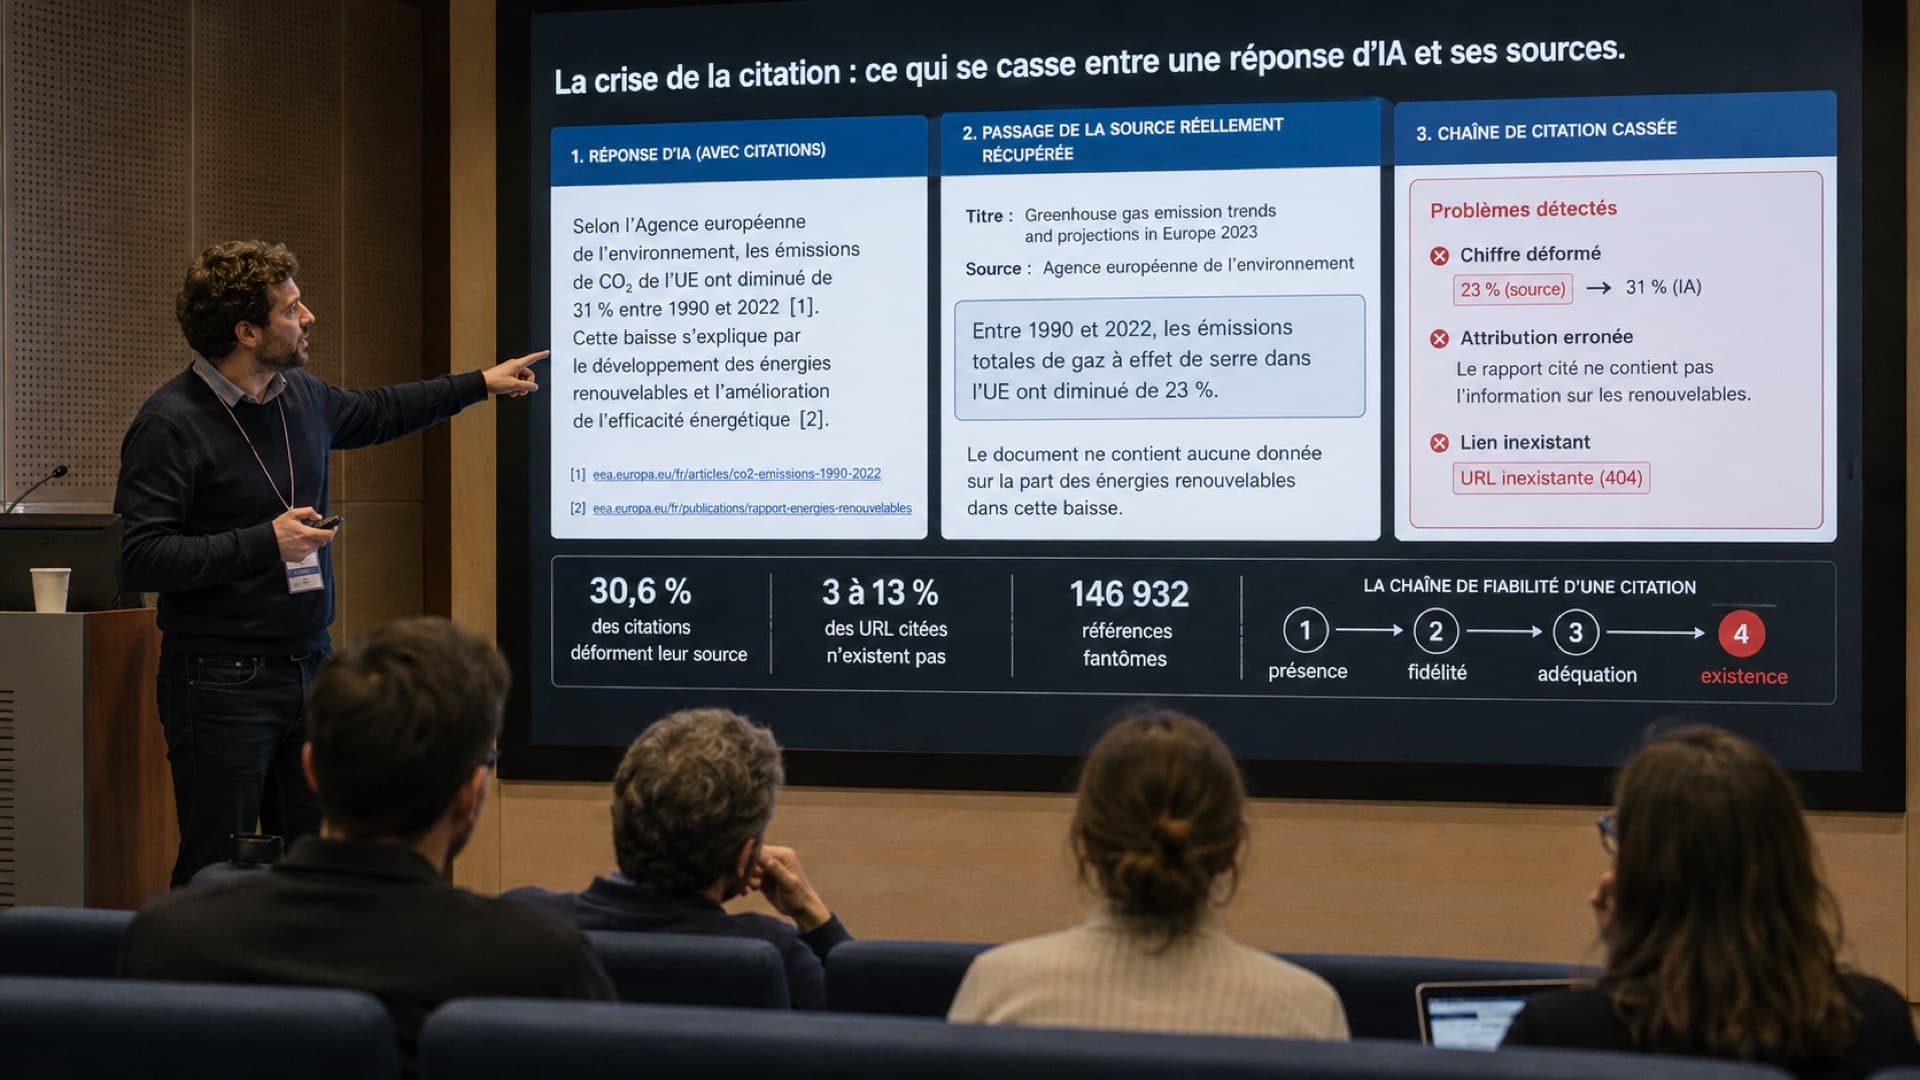
En février 2025, la BBC a publié un test conduit en décembre 2024 : 100 questions d’actualité posées à 4 assistants (ChatGPT, Copilot, Gemini, Perplexity). Ses journalistes ont jugé que 51 % des réponses présentaient un problème significatif. Parmi les réponses citant un contenu de la BBC, 19 % y introduisaient une erreur factuelle, et 13 % des citations attribuées à ses articles étaient modifiées ou absentes de l’article cité.
L’Union européenne de radio-télévision (UER) et la BBC ont élargi le protocole en octobre 2025 à 22 médias publics, 18 pays et 14 langues. Sur 2 709 réponses générées entre le 24 mai et le 10 juin 2025 par les versions gratuites des 4 mêmes assistants, 45 % comportaient au moins un problème significatif. Le sourçage en était la première cause (31 % des réponses), devant l’exactitude (20 %). Gemini présentait un problème significatif dans 76 % de ses réponses.
Le Tow Center de la Columbia Journalism Review a testé en mars 2025 une tâche plus étroite, retrouver l’article d’origine d’un extrait : sur 1 600 requêtes adressées à 8 moteurs, plus de 60 % des réponses étaient fausses, de 37 % pour Perplexity à 94 % pour Grok 3. Dès 2023, un audit de Stanford relevait que seules 51,5 % des phrases produites par 4 moteurs étaient entièrement étayées par leurs citations.
Ces chiffres, tirés de l’actualité et de versions de modèles datées, ne se transposent pas à la description d’une entreprise. Ils établissent 2 points : une réponse sourcée peut être fausse, et la source affichée ne garantit pas que l’énoncé en provient.
Les entreprises peu documentées, terrain le plus fragile
Sur la variable qui concerne la plupart des PME et ETI, la rareté de l’information publique, 2 travaux académiques convergent. L’étude PopQA (Mallen et al., ACL 2023) montre, sur 14 000 questions et 10 modèles, que les modèles retiennent mal les faits relatifs aux entités peu connues, que l’augmentation de taille y remédie peu, et que la consultation de documents avant réponse améliore nettement le résultat.
WildHallucinations (Zhao et al., Allen Institute for AI et universités partenaires, juillet 2024) part de 7 919 entités demandées à des assistants, dont la moitié n’a pas de page Wikipédia. Sur 118 785 textes produits par 15 modèles, les erreurs sont plus fréquentes pour les entités sans page Wikipédia, et l’ajout d’une recherche documentaire les réduit un peu sans les supprimer.
Le mécanisme est lisible : faute de textes, le modèle comble le manque avec les régularités du secteur. Un homonyme mieux documenté, une activité cédée mais abondamment couverte, une crise ancienne plus commentée que la reprise qui a suivi peuvent alors dominer la réponse. Ce dernier cas reste une hypothèse, qu’aucune des études citées ne mesure.
Une prépublication de l’université de Toronto (Chen, Wang, Chen et Koudas, septembre 2025, non évaluée par des pairs) ajoute un élément sur les sources : les moteurs génératifs étudiés privilégient nettement les sources tierces jugées faisant autorité, au détriment des contenus des marques et des réseaux sociaux, bien plus que Google. Si ce résultat se confirme, les écrits de tiers pèsent plus que le site de l’entreprise.
Ce que l’étude GEO de Princeton établit, et ses limites
L’étude « GEO: Generative Engine Optimization » (Aggarwal et al., Princeton et IIT Delhi, KDD 2024) est souvent résumée en une promesse de 40 % de visibilité en plus, lecture trop large. Les auteurs ont simulé un moteur : les 5 premiers résultats Google d’une requête, puis une réponse rédigée par GPT-3.5 Turbo à partir de ces textes. Sur 10 000 requêtes, ils ont réécrit l’une des sources et mesuré la part de la réponse qui en provient, pondérée par sa position.
Ajouter des citations, des extraits ou des statistiques augmente cette part de 30 à 40 %, le bourrage de mots clés n’apporte presque rien, et le gain est maximal pour les sources mal classées (plus 115 % pour le site classé 5e avec la citation de sources). Un test sur Perplexity (200 requêtes) donne 22 % à 37 % selon la métrique. L’étude mesure donc la reprise d’un texte déjà retenu comme source. Elle ne mesure ni la mention spontanée d’une marque, ni l’exactitude de ce qui est dit d’elle. Elle justifie d’écrire des pages factuelles et sourcées, pas de promettre qu’une entreprise sera citée.
Qui répond d’une information fausse générée
Dans Moffatt c. Air Canada (tribunal civil de Colombie-Britannique, 14 février 2024), la compagnie a répondu d’une information erronée donnée par l’agent conversationnel de son site sur les tarifs de deuil, l’agent faisant partie d’un site dont elle répondait en entier.
Contre un éditeur d’IA, le premier jugement connu est défavorable au plaignant. Le 19 mai 2025, la cour supérieure du comté de Gwinnett (Géorgie) a rejeté la plainte en diffamation de Mark Walters contre OpenAI : ChatGPT avait inventé un détournement de fonds, mais ni la faute exigée pour une personnalité publique ni un préjudice n’étaient démontrés.
Le cas le plus proche d’une entreprise ordinaire est pendant. L’installateur solaire Wolf River Electric poursuit Google depuis mars 2025, car l’aperçu généré par IA affirmait que le procureur général du Minnesota l’avait assigné, ce que les sources citées ne disaient pas. L’entreprise invoque des contrats résiliés et un préjudice de 110 à 210 millions de dollars. Le 9 janvier 2026, un juge fédéral a renvoyé l’affaire devant la justice de l’État. Rien n’est jugé sur le fond.
En Europe, la voie ouverte passe par les données personnelles, donc par les dirigeants plutôt que par la société. En mars 2025, l’association noyb a saisi l’autorité norvégienne de protection des données pour un homme que ChatGPT présentait comme le meurtrier de ses enfants, en invoquant l’obligation d’exactitude de l’article 5 du RGPD. Dans les sources consultées, aucune décision française ne tranche la responsabilité d’un éditeur d’assistant pour la description fausse d’une société.
Tester ce que disent les assistants : un protocole proposé
Faute d’étude sur les entreprises, la mesure valable est celle que vous conduisez. Le protocole suivant produit un relevé d’écarts, sans score.
- Une fiche de vérité : 10 à 15 faits vérifiables (siège, activités actuelles et cédées, dirigeants, dates clés), chacun avec sa pièce publique.
- Des requêtes en 4 familles : identité (« Qu’est-ce que [nom] ? »), faits (« Qui dirige [nom] ? »), réputation (« Quelles critiques vise [nom] ? ») et secteur sans le nom (« Quels prestataires pour [besoin] en [région] ? »).
- Des conditions consignées : assistant, offre gratuite ou payante, recherche web active ou non, langue, date, session neuve sans mémoire.
- Au moins 3 passages par requête, car les réponses varient d’un tirage à l’autre ; l’étude de Princeton échantillonnait 5 réponses.
- Un codage de chaque écart selon les critères de l’UER (exactitude, sourcing, distinction entre fait et opinion, contexte), par 2 personnes, avec la source affichée pour chaque erreur, et des captures datées archivées.
Une erreur qui renvoie à votre site se corrige chez vous ; à un article tiers, elle appelle une demande de mise à jour à son éditeur ; sur un dirigeant, elle ouvre les droits d’accès et de rectification du RGPD auprès de l’éditeur de l’assistant. Sans source identifiable, l’erreur signale un manque de documentation publique, que seule une information exacte publiée par vous et par des tiers réduira, sans délai garanti.
La direction de la communication porte ce relevé, avec le juridique pour les erreurs graves. Déclencheurs : levée de fonds, cession, changement de dirigeant, crise, et à défaut un passage par trimestre. Le coût est du temps, de l’ordre d’une journée pour 20 requêtes sur 3 assistants, estimation à ajuster. Une étude publiée montrant des erreurs rares et stables sur les entreprises justifierait d’espacer ce contrôle. Notre checklist d’audit GEO détaille la rédaction de pages citables, et notre dossier sur le GEO en pose le cadre.
Le fait qui permettra de vérifier cette lecture
Le jugement au fond de Wolf River Electric contre Google, devant la justice du Minnesota, serait la première décision sur la responsabilité d’un moteur pour la description fausse d’une entreprise. S’il écarte cette responsabilité, la correction des sources tierces restera la seule voie praticable pour une société. La décision norvégienne sur la plainte de noyb dira si l’exactitude exigée par le RGPD s’impose aux réponses d’un assistant.
Mise à jour du 25 septembre 2026
Dans les sources consultées le 25 septembre 2026, nous n’avons identifié ni jugement au fond dans l’affaire Wolf River Electric, renvoyée devant le tribunal du comté de Ramsey, ni décision publiée de l’autorité norvégienne sur la plainte de noyb. ELMARQ a depuis analysé une revue critique de 45 études sur le GEO et analysé l’écart entre la source citée par une IA et ce qu’elle en rapporte.
Réécriture du 25 septembre 2026. La version du 11 mars 2026 reposait sur des « tests sur 200 entreprises françaises entre 2024 et 2026 » dont aucune donnée n’existe, et dont la période précède l’immatriculation d’ELMARQ, le 23 avril 2026. Sont retirés les 4 profils chiffrés (43 %, 28 %, 22 % et 7 %), le taux de 12 % d’hallucinations, les 2 anecdotes clients, un exemple de confusion d’homonymes, la mention de 20 entreprises accompagnées, le tableau sectoriel, le délai de rééquilibrage de 12 à 18 mois et le cadre « Empreinte Narrative IA » avec son score de tonalité, faute de données ; les dates de coupure des modèles, périssables, sont aussi retirées. L’article s’appuie désormais sur 7 études de fiabilité identifiées, sur une lecture corrigée de l’étude GEO de Princeton (reprise d’une source, non citation d’une marque) et sur 4 affaires ou plaintes. La méthode de test est un protocole proposé, sans résultat.